Jemand in Ihrer Buchhaltung kopiert eine Mandantenrechnung in ChatGPT, um schnell eine Kontierung zu klären. Harmlos gemeint, und trotzdem hat gerade ein fremdes Unternehmen personenbezogene Daten Ihres Kunden gesehen. An dieser Stelle entscheidet sich, welche Art von KI zu welcher Aufgabe passt.
Große Sprachmodelle sind in den meisten Betrieben angekommen. Die Frage ist selten mehr, ob KI zum Einsatz kommt, sondern in welcher Bauform. Es gibt dafür drei grundverschiedene Ansätze, jeder mit eigenen Stärken, Kosten und rechtlichen Folgen.
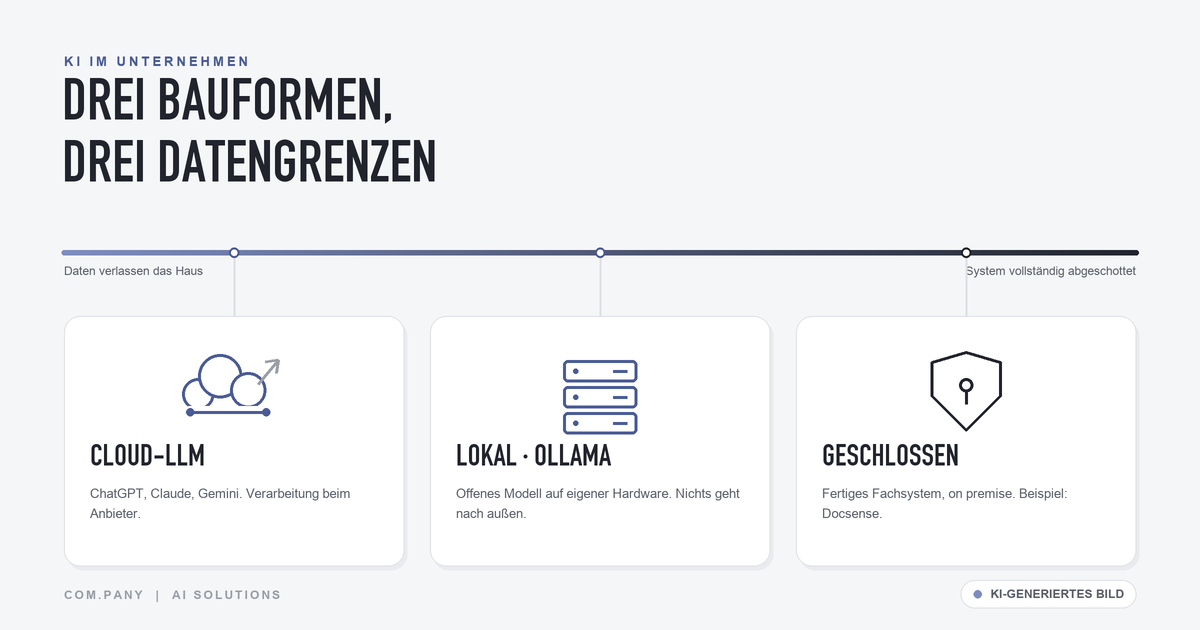
Wir sortieren sie entlang der Achse, die für die meisten Organisationen zählt: Wie weit verlassen Ihre Daten das Haus?
Cloud-LLMs: die öffentlichen Dienste
Gemeint sind ChatGPT, Claude, Gemini, Microsoft Copilot und vergleichbare Angebote. Ihre Eingabe geht an die Server des Anbieters, das Modell rechnet dort, die Antwort kommt zurück. Betrieb, Wartung und Weiterentwicklung liegen komplett beim Anbieter.
Der Vorteil ist Tempo und Qualität. Sie haben ohne eigene Hardware Zugriff auf die stärksten verfügbaren Modelle, große Kontextfenster, Bild- und Sprachverarbeitung, und jede Verbesserung steht sofort zur Verfügung. Der Einstieg kostet fast nichts.
Die Kehrseite ist Abhängigkeit. Preise, Verfügbarkeit und Modellverhalten bestimmt der Anbieter, ein Modell kann sich über Nacht ändern oder ganz wegfallen. Die laufenden Kosten steigen mit der Nutzung. Und die Daten liegen zumindest während der Verarbeitung außerhalb Ihrer Kontrolle.
Beim Datenschutz brauchen Sie einen Auftragsverarbeitungsvertrag, eine Rechtsgrundlage für die Verarbeitung und Klarheit darüber, ob Ihre Eingaben zum Training verwendet werden. In den Business- und Enterprise-Tarifen der großen Anbieter ist das Training auf Kundendaten meist ausgeschlossen, oft ist auch EU-Hosting wählbar. Der Datentransfer in die USA stützt sich derzeit auf das EU-US Data Privacy Framework, dessen Bestand politisch nicht gesichert ist. Besondere Datenkategorien wie Gesundheits- oder Personaldaten gehören ohne sehr genaue Prüfung nicht in einen öffentlichen Dienst.
Nach dem AI Act gilt der Modellanbieter als Anbieter eines KI-Modells mit allgemeinem Verwendungszweck und trägt seit August 2025 eigene Pflichten, etwa zu technischer Dokumentation und Urheberrecht. Sie selbst sind Betreiber. Daraus folgen Transparenzpflichten gegenüber Ihren Nutzern und, seit Februar 2025, die Pflicht, für ausreichende KI-Kompetenz im Haus zu sorgen. Im Hochrisiko-Einsatz kommt deutlich mehr dazu.
Lokal betriebene Modelle: Ollama und Co.
Hier laufen offene Modelle wie Llama, Mistral, Qwen oder Gemma auf Ihrer eigenen Maschine oder Ihrem eigenen Server. Werkzeuge wie Ollama, LM Studio oder vLLM machen das inzwischen mit überschaubarem Aufwand möglich. Nichts geht nach außen.
Warum sich immer mehr Unternehmen für diesen Weg entscheiden, vertieft der Beitrag Der Weg zum eigenen LLM.
Dafür bekommen Sie Kontrolle. Die Daten bleiben im Haus, die Kosten sind planbar, weil Sie Hardware statt einzelner Anfragen bezahlen. Das Modell lässt sich einfrieren, damit Ergebnisse reproduzierbar bleiben, und mit eigenen Daten über Fine-Tuning oder eine angebundene Wissensdatenbank ergänzen. Vom konkreten Modell sind Sie nicht abhängig, es lässt sich austauschen.
Der Preis dafür ist Eigenverantwortung. Sie brauchen passende Hardware, und Betrieb, Absicherung, Updates und Überwachung sind Ihre Aufgabe. Skalierung auf viele gleichzeitige Nutzer kostet Geld und Know-how.
Dazu kommt eine Grenze im Können. Die frei laufenden Modelle sind stark bei klar umrissenen Aufgaben: zusammenfassen, formulieren, aus Dokumenten Angaben ziehen, sortieren, einfache Fragen beantworten. Bei langen Gedankenketten, Spezialwissen oder vielstufigen Aufgaben reichen sie an die großen Cloud-Modelle meist nicht heran. Ein lokales LLM ist außerdem ein Werkzeug für Sprachaufgaben und keine Plattform für eigenes Machine Learning oder Deep Learning. Wer Modelle selbst trainieren, Bild- oder Sensordaten auswerten oder Prognosen rechnen will, braucht anderes Werkzeug und deutlich mehr Rechenleistung. Die Stärke liegt in der einfachen, wiederkehrenden Arbeit.
Beim Datenschutz wird die Lage deutlich einfacher. Keine Auftragsverarbeitung nach außen, kein Drittlandtransfer, der Nachweis gegenüber einer Aufsichtsbehörde ist leichter zu führen. Dafür verantworten Sie Zugriffsschutz, Protokollierung und Löschkonzept jetzt selbst. Lizenz und Herkunft des Modells sollten Sie prüfen, denn manche als offen bezeichnete Modelle haben Nutzungsbeschränkungen.
Nach dem AI Act bleiben Sie Betreiber, solange Sie ein offenes Modell nur intern einsetzen. Verändern Sie es wesentlich oder geben Sie es unter eigenem Namen weiter, können Sie selbst zum Anbieter werden, mit den entsprechenden Dokumentationspflichten. Für frei lizenzierte Modelle entfallen einzelne dieser Pflichten, nicht aber bei systemischem Risiko oder in einer Hochrisiko-Anwendung.
Geschlossene Fachsysteme: das Prinzip hinter DOCSENSE
Die dritte Bauform ist ein fertiges Fachsystem, in dem KI steckt, das aber vollständig abgeschottet arbeitet. Kein Cloud-Aufruf, kein Datenabfluss, ein fest umrissener Funktionsumfang. Ein Beispiel aus unserem eigenen Umfeld ist DOCSENSE. Das System erfasst Dokumente, Bilder und Daten, zieht die relevanten Inhalte heraus, erkennt Muster und verknüpft die Informationen zu auswertbarem Wissen. Es läuft ausschließlich on premise. Alle Informationen bleiben im Unternehmen oder in der Institution, es gibt keine externe Verarbeitung und kein gemeinsames KI-Modell über mehrere Kunden hinweg.
Wie so ein Zuschnitt konkret aussieht, zeigt Tax Logic, eine Anwendung von Docsense für Steuerberatungskanzleien, die gerade in der Trainingsphase steckt. Sie automatisiert die Einnahmen-Ausgaben-Rechnung. Bankdateien im Format CAMT.053 werden eingelesen, parallel analysiert die KI gescannte und digitale Rechnungen sowie Kassa-, Kreditkarten- und Bankbelege, ordnet sie den Transaktionen zu und schlägt die Kontierung vor. Das ist kein Allzweck-Chat, sondern ein Werkzeug für genau einen Arbeitsablauf.
Der Gewinn ist maximale Datenhoheit bei klarer Verantwortung. Weil der Funktionsumfang fest ist, lässt sich das System testen, abnehmen und auditieren, und es ändert sich nicht von selbst. Die Verarbeitung ist auf eine bestimmte Dokumentenart und einen Fachprozess zugeschnitten und dadurch oft treffsicherer als ein Allzweckmodell.
Für Datenschutz und AI Act ist das die stärkste Ausgangslage. Die Verarbeitung ist vollständig kontrollierbar, eine Datenschutz-Folgenabschätzung ist leichter zu erstellen, sensible Daten aus Gesundheit, Justiz, Personal oder Finanz sind hier am besten aufgehoben. Auch die Risikoeinstufung nach dem AI Act wird überschaubar, weil der Einsatzzweck klar abgegrenzt ist. Fällt der Anwendungsfall in einen Hochrisiko-Bereich, sind die seit August 2026 geltenden Pflichten einzuhalten, und ein abgegrenztes System ist dafür leichter zu dokumentieren als ein offener Chat-Zugang.
Nicht alles ist für alles geeignet
Die drei Ansätze konkurrieren weniger, als es scheint. In der Praxis laufen sie nebeneinander.
Für Recherche, Textentwürfe, Brainstorming, Programmierung und unkritische interne Aufgaben ist ein Cloud-LLM die richtige Wahl. Schnell und stark, und der Datenschutzaufwand bleibt beherrschbar, solange nichts Sensibles hineingeht.
Sobald interne Dokumente mit Personenbezug, Betriebsgeheimnisse oder Daten aus einem verschwiegenheitspflichtigen Bereich im Spiel sind, gehört die Verarbeitung auf ein lokales Modell oder in ein geschlossenes System.
Für einen wiederkehrenden, klar umrissenen Fachprozess mit sensiblen Unterlagen, etwa Akten, Befunde oder Verträge, ist das geschlossene Fachsystem die naheliegende Lösung.
Vier Fragen helfen bei der Einordnung: Wie sensibel sind die Daten? Wie klar ist der Anwendungsfall abgegrenzt? Brauchen Sie Spitzenqualität oder reicht ein solides Ergebnis? Und haben Sie die Kompetenz im Haus, ein Modell selbst zu betreiben?
Die Frage ist also nicht, welches Modell das beste ist. Sie lautet: Welche Bauform passt zu diesem einen Anwendungsfall? Bei genau dieser Einordnung unterstützen wir von com.pany | ai solutions Sie, von der Risikoklasse über die Modellauswahl bis zum Prototyp und zum laufenden Betrieb.